紅樓夢角色
紅樓夢模擬器是一個會把 120 回演一遍的敘事引擎。角色說話要有立繪、說到傷心處要換一張、場景切換要有背景、每一回要有一張回目圖 —— 全部加起來 833 張,而原著裡有名有姓的人物有好幾百個。
這頁講的是那 833 張怎麼生出來的,以及為什麼中間丟掉過一整批。
62 個有名有姓的角色#
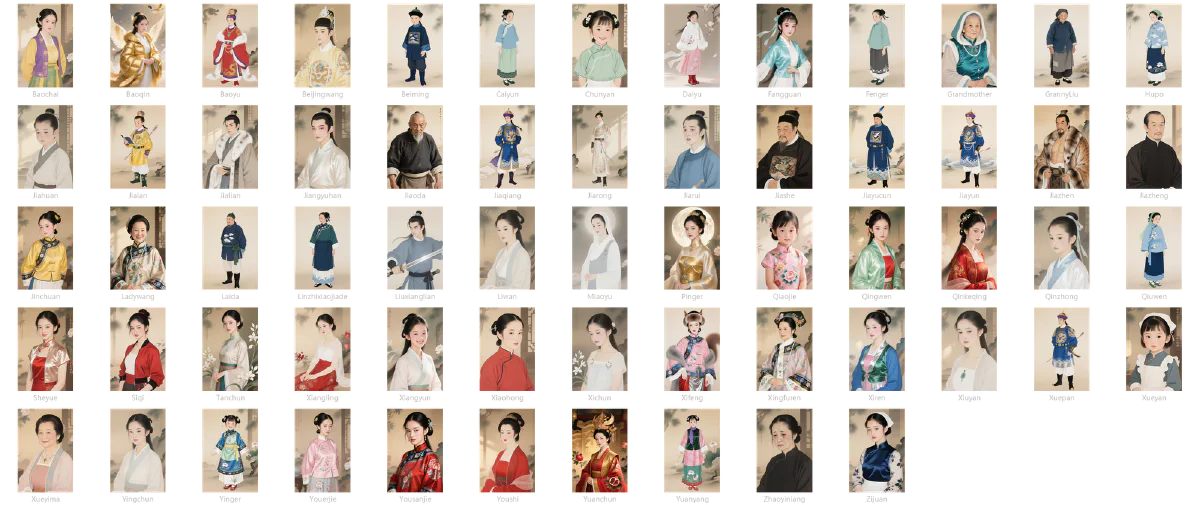
每個人八種表情,而且臉以外的地方一動也不動#
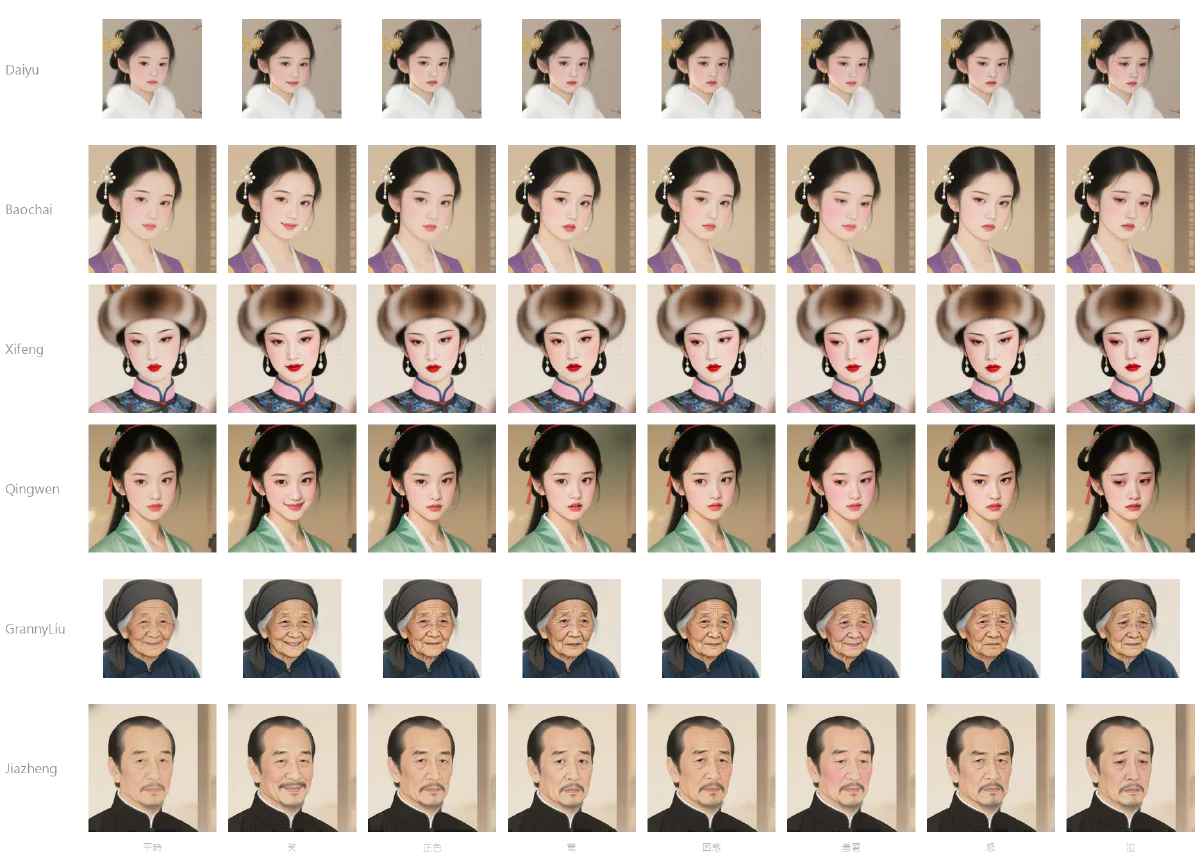
這是這批跟一般做法最大的差別。
生成模型沒有記憶。你為「黛玉.笑」重寫一次提示詞,它就重新想像一次這個人:換髮型、換臉型、換一套衣服,然後你得到八張互不相干的圖。常見的補救是找一組跨張不變的錨(例如把服裝主色寫死),讓讀者至少認得出是同一個人 —— 這能用,但你仔細看還是會發現人在飄。
這批走的是另一條路:不重畫,只改臉。
每個角色先生一張基準立繪。之後七種表情不是新的生成任務 —— 是把那張基準圖讀回來,用臉部偵測框出五官,只對那一塊重新擴散,然後貼回原圖。框外的像素從頭到尾沒有進過模型。
所以一致性不是「調到很像」,是結構上不可能不像。
代價是姿勢固定了。八張的手勢、站姿完全一樣,情緒全靠臉。對敘事引擎來說這是划算的交換:立繪是配在對話框旁邊的,讀者的視線本來就在臉上。
八種表情是這樣分的:
portrait 平時 | laughing 笑 | serious 正色 |
surprised 驚 | confused 困惑 | embarrassed 羞窘 |
angry 怒 | crying 泣 |
沒名字的那幾百個人,靠 16 個原型#
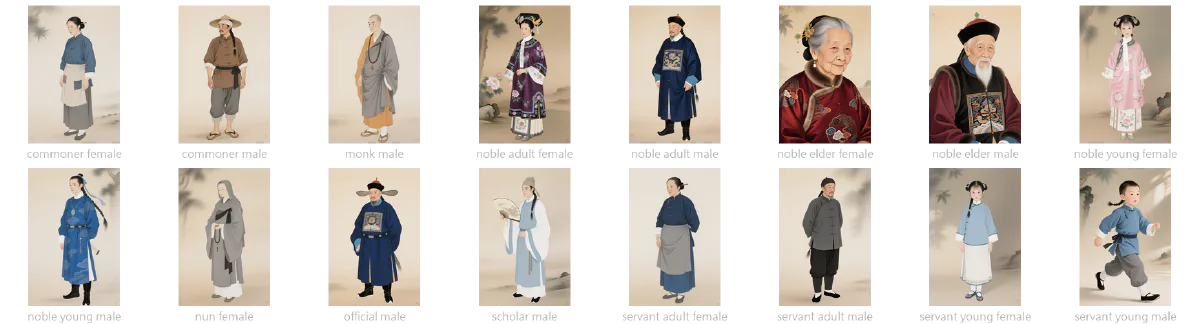
120 回裡走過的人遠不只 62 個。門房、小廝、婆子、道士、來收租的、來報喪的 —— 這些人有一兩句話,然後就消失了。替他們每人畫一張,成本上做不到;讓他們沒有立繪,畫面上又會缺一塊。
所以切出 16 個原型:階級(平民 / 貴族 / 僕役 / 出家 / 官 / 士)× 性別 × 年齡(少 / 壯 / 老)。每個原型一樣有完整八種表情,所以一個沒名字的婆子照樣可以在挨罵時換成怒、在報喪時換成泣。
這個決定是整批素材裡投資報酬率最高的一個:16 × 8 = 128 張,接住了幾百個角色。
89 處地景#
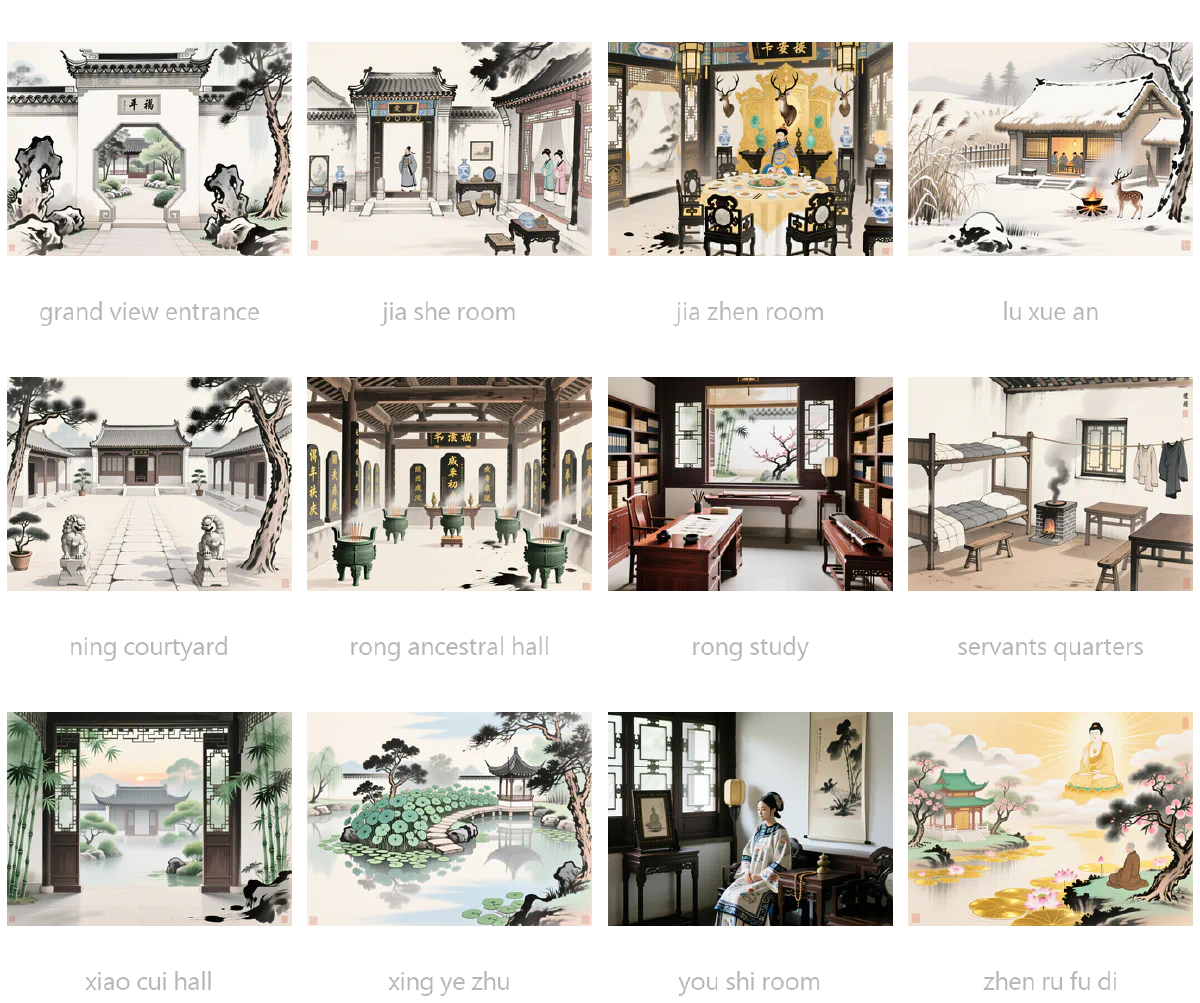
120 回,一回一張#
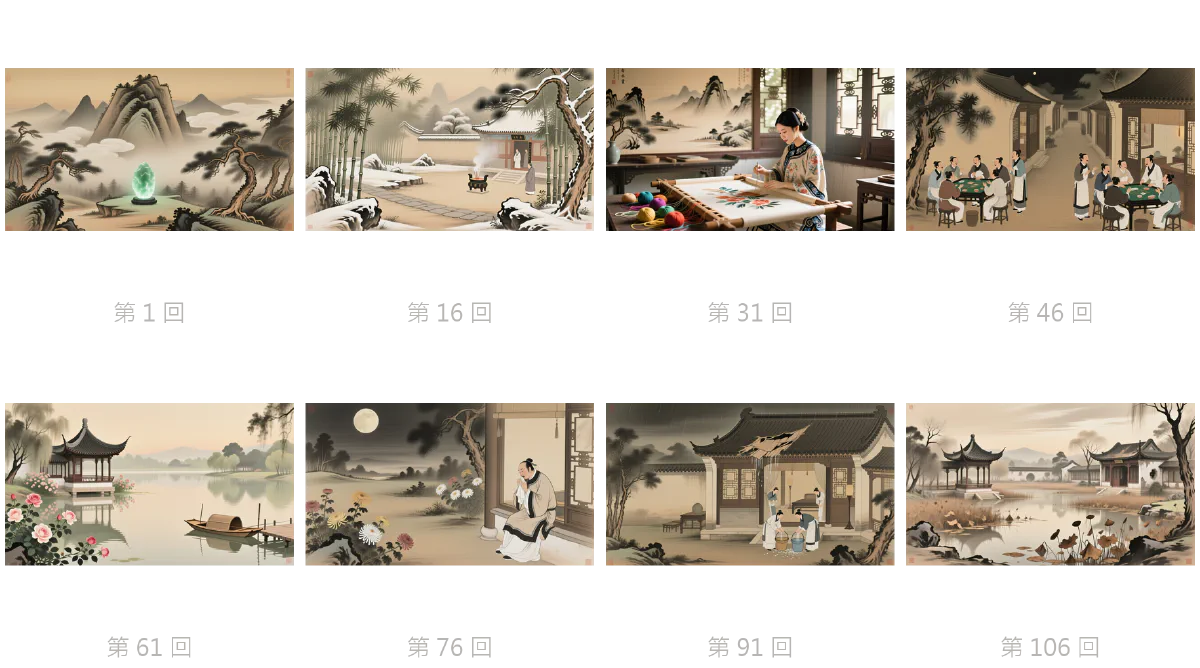
講一點做法#
一、先定裝,再演戲。 每個角色的第一張是「定裝照」:姿勢、服裝、配飾、背景一次決定完。之後七種表情都掛在它下面。這個順序決定了整批的一致性上限 —— 定裝照錯了,八張一起錯。
實際的兩段流程長這樣(本機 GPU 跑 ComfyUI,沒有雲端 API):
| 基準立繪 | 七種表情 | |
|---|---|---|
| 起點 | 空白 latent 512×768 | 讀回基準立繪那張 PNG |
| 取樣 | 全圖,denoise 1.0 | 只在臉的框內,denoise 0.5 |
| 臉怎麼框 | —— | YOLOv8 臉部偵測 → 外擴後裁下、放大、重繪、羽化貼回 |
| 步數 | 8 步 | 8 步 |
denoise 0.5 是整件事的樞紐:留一半原圖。全部重畫(1.0)臉會換人,動太少(0.2 以下)表情推不動。而且重繪只發生在框裡,框外連碰都沒碰到 —— 那才是圖 2 裡髮絲和衣領一個像素都沒變的原因,不是我調得好。
框的處理也有講究:偵測到的臉往外擴一圈、再以三倍範圍裁下來送進模型,最後羽化幾個像素貼回去。擴太少會在下巴留下接縫,擴太多就等於重畫整張。
二、表情提示詞是「加一句」,不是「換一段」。 七種表情的正面提示詞,前面那一整段角色描述(年紀、五官、服裝、畫風)一字不改,只在尾巴接一句表情:
(基準句原封不動)… high-fidelity masterpiece
                  ↑ 到這裡都一樣
, slightly misty eyes, gentle melancholy, restrained sorrow,
dignified sadness, subtle downcast gaze, composed grief而且寫的是動作不是形容詞。「悲傷的」會得到一張表情曖昧的臉;「眼睫微濕、視線下垂、神色克制」會得到你要的那張。模型對形容詞的解讀空間太大,對動作的解讀空間小。
三、負面提示詞要擋掉的是「其他情緒」和「用力過猛」。 每一種表情的負面詞都在基準負面詞後面追加兩類東西:其他六種情緒(免得模型混著給),以及那一種情緒的誇張版——
crying  的負面: …, smiling, happy, laughing,
                 exaggerated crying, open mouth wailing, childish expression
angry   的負面: …, smiling, happy, laughing, crying,
                 exaggerated rage, bared teeth, open mouth screaming, childish tantrum
第二類才是關鍵。生圖模型對「哭」的預設是嚎啕大哭、對「怒」的預設是齜牙咧嘴 —— 那是表情符號的語彙,不是這批畫的語彙。這些人是世家子弟,情緒要收著。「不要什麼」在這裡比「要什麼」還吃力氣。
四、八種是從調用端反推的,不是憑感覺定的。 敘事引擎要能自動選表情,它能從一句台詞判斷出來的粒度就是這八種。多做第九種,程式沒有足夠資訊去選它,做出來只會躺在資料夾裡。先看調用端能分辨到什麼,再決定素材要做幾種。
五、素材庫跟 app 分開放。 833 張、快 400 MB,塞進 app bundle 會直接撞到 App Store 的體積限制。所以它是一個獨立的素材倉庫,app 在需要時才去拉。這也讓補圖、換圖不必重新送審。
六、丟掉過一整批。 更早有一版是「20 個角色 × 3 種表情」,走的是工筆半身像加題款、靠服裝主色維持辨識度那條路。它能用,但兩個問題:三種表情不夠敘事引擎分派,而且同一個人在不同表情之間看得出來在飄。現在這批是重做的 —— 保留下來的只有角色名單。
沒講的部分#
- 62 個角色的定裝提示詞本身 —— 每個人的「身分區塊」怎麼寫,才在八張之間撐得住
- 臉框在什麼髮型與角度上會偵測失敗,以及那時候的退路
- 16 個原型的維度是怎麼收斂成這 16 格的
- 120 回插畫怎麼從回目文字產生構圖,以及季節與時辰的連續性怎麼維持
- 實際良率、重跑一張的成本、以及哪一種表情最難生(不是哭)
- 敘事引擎那端怎麼決定某一句台詞該配哪一種表情
這些參數不是我記在腦子裡的 —— 每張 PNG 都把當初的完整流程寫在自己的中繼資料裡,所以兩年後看到一張圖,直接從檔案讀回模型、種子、提示詞、denoise。這頁的每個數字都是這樣挖出來的,不是憑印象寫的。
這批角色也撐起了一套 LINE 貼圖。想看同一套「先鎖常數、再放變數」用在完全不同的題材上,素材圖庫是同一個想法跑 2,545 次的樣子。