系統發生問題的時候,大部分時間不是花在修復,而是花在尋找原因,多數問題可以在二十分鐘內收斂,但少數幾次會拖垮一整週。
少數幾次之所以會拖這麼久,通常不是因為問題特別困難,而是人類排查的時候只能一條一條試。
一、反覆試驗:那個不被視為產出的部分#
先講試錯。
大致上我們可以遵循指南,但在實際的場景裡總會有各種各樣的問題,比如權限不夠、安裝的時候硬碟空間不夠、有幾個參數甚至參數之間的排列組合需要反覆嘗試,直到最後每一個問題都排除,系統才會以我們預期的狀態跑起來。
這種種的過程非常耗時間且無趣,而且更現實的是,這不是造火箭,試錯本身被視為勞力活,不是高價值產出。
試了四十次不會有人稱讚你,大家只會問為什麼還沒好。
在 agent harness1,比如 looping、tool calling 足夠進步之後,agent 已經可以不斷除錯直到最終目標完成,除非它有必要的資訊無法取得、或者需要人類授權才會停下來。
這件事的意義是,那四十次嘗試從你的時間表上消失了,變成一段等待。
二、排查:人類的搜尋只能是序列的#
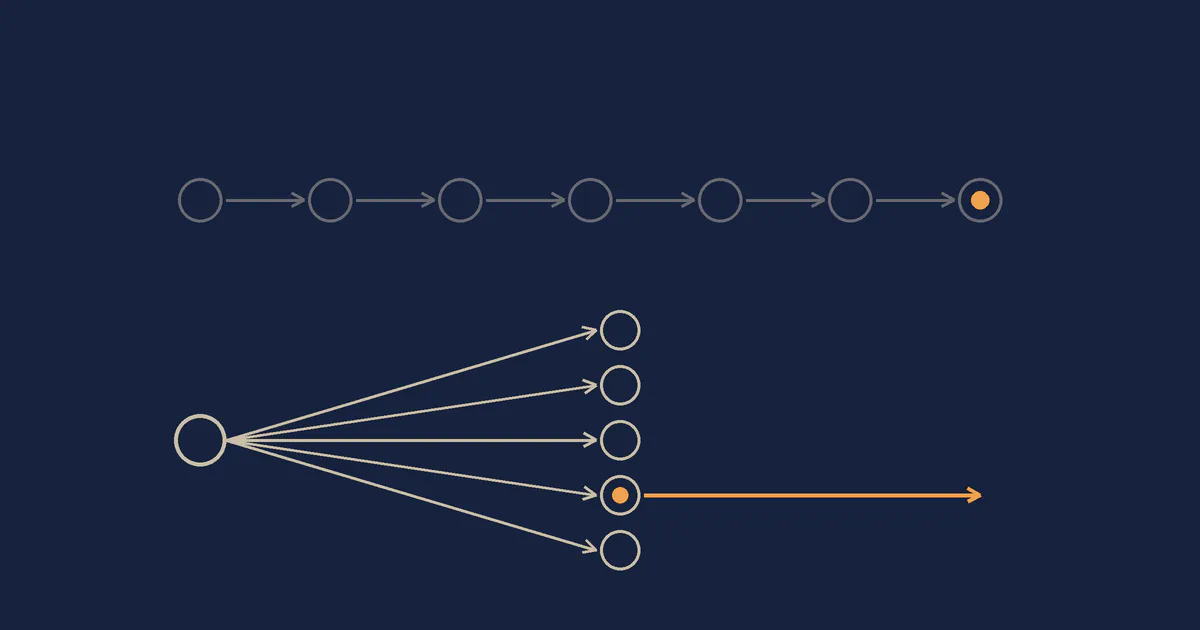
排查錯誤原因的時候,如果是我手動操作,只能緩慢地從可能性最高的問題點開始排查,確認不是 root cause 之後再查下一個。
這是完全理性的策略,但它有一個致命的性質,當問題恰巧是機率最低的那個,整段排查時間就會拉得非常長。
而 agent 可以派遣 sub agent 並行處理2,人類只能一條一條試,它可以全部一起試,長尾的那一端就是這樣被砍掉的。
三、還有一件事:它同時扮演所有分工#
這一點我覺得比並行更重要。
以往在組織內部,一個問題原本需要四五個不同專業的窗口一起討論,光是交換資訊、確認資訊就非常耗時,並且牽扯到人就會有政治問題。
而大多數時候甚至不是政治,是每個人都很忙,根本無法靜下心來交換資訊,總希望其他人先查完再換自己查,於是問題就在幾個窗口之間來回,每來回一次往往就是一天。
AI 同時扮演所有分工的角色,沒有資訊交換跟分工的窒礙,查問題的時候往往能夠收斂到正確答案,或者兩三個候選的問題上。
它的知識面也確實比任何單一窗口廣,它不是每一項都比專家強,但它每一項都在及格線以上,而且它不用被排進誰的行事曆。
實務上怎麼用#
三個我實際在做的:
- 先讓它列假設,再讓它查,直接叫它「修好」會得到一個能動但你不知道為什麼能動的結果,先要一份候選清單,你會知道它在找什麼。
- 把日誌、設定、環境資訊一次餵給它,排查的品質幾乎完全取決於它看得見多少,看不見的部分它會用猜的,而它猜得很有說服力。
- 並行的數量以你審得動為上限,開五路同時查,然後五個結論你都只掃過一眼,等於沒查。
如果你手上有一類問題每次都要花掉一整週,而且每次原因都不一樣,那類問題的成本其實不在修理,在搜尋。